20 mars 2013

Comment fonctionne Google News ?

Je suis un blogueur politique, passionné par ça. Pour moi, les deux informations importantes, aujourd'hui, sont la démission de Jérôme Cahuzac, ministre du budget, et le débat sur la motion de censure, aujourd'hui. Or aucune de ses informations ne figurait en une de Google News, ce matin. C'est étrange.

Je me suis toujours demandé comment était formée cette page, ce que les robots ont dans le ciboulot !

Si vous avez des informations...

Google News précise : "Nos articles sont sélectionnés et classés par des ordinateurs qui s'appuient sur divers facteurs, tels que la fréquence de diffusion d'une information en ligne et les sites sur lesquels celle-ci apparaît. Par conséquent, les articles sont triés sans tenir compte de leur orientation politique ou idéologique, et vous pouvez choisir à partir d’une large variété de perspectives."

19 mars 2013

Netvibes pour les nuls


Je parle d’abonnement aux blogs tous les jours, ici, mais j’oublie que les lecteurs de mes autres blogs ne sont pas tous geeks… Bien au contraire. Je vais donc faire un billet de présentation de Netvibes. Ceux qui connaissent, vous pouvez tourner le dos.

Qu’est-ce qu’un abonnement ?

A côté des blogs, un petit fichier, appelé « flux RSS » (souvent à tort, d’ailleurs, puisqu’il peut s’agir un « flux ATOM » mais on s’en fout) est généré. Il contient les derniers billets d’un blog. Des logiciels, appelés « agrégateur de flux » ou « lecteurs de flux », permettent d’afficher ces fichiers pour tous les blogs auxquels on est « abonné ».

Voir la première illustration. Je suis abonné à plus de 300 blogs. Ils sont triés par signet. Le premier est « amis » mais celui ouvert dans l’écran est « leftblogs ». On voit au bout de la flèche rouge qu’il y a un billet que je n’ai pas encore lu dans le blog « Du trASh et DeS baSIerS ».

Cliquez sur les illustrations pour les agrandir.

Créer un compte Netvibes

Vous allez sur http://www.netvibes.com/fr et vous cliquez sur « Netvibes for Individuals » :


Cliquez ensuite sur « Devenez Basic ». Vous obtenez ceci.


Je vais saisir « blogs politiques ». Là, il faut attendre quelques secondes avant que le machin dise « c’est fait ».


Choisissez une illustration au hasard et cliquer sur le machin vert pour obtenir un nouveau bel écran avec un gros pavé vert « Suivant » dont au sujet duquel j’ai la flemme de faire une copie d’écran. Vous cliquez sur « passer l’assistant ».


Vous cliquez sur « inscription » en haut à droite. Et vous remplissez le formulaire (je vous rappelle qu’on ne « renseigne » pas un formulaire) avec tous les trucs y compris l’affreux code en bas. Dans mon exemple, j’ai mis une majuscule à mon « nom d’utilisateur », il m’encadre la zone en rouge parce que c’est interdit.

Là vous validez, vous cochez, vous revalidez… Le machin vous envoie un mail. Vous allez dans votre messagerie, vous ouvrez le mail, vous cliquez sur « Validez le mail ». Vous arrivez sur un écran splendide comme celui-ci.


Le machin a déjà sélectionné un contenu. Dans mon exemple, j’ai plusieurs pavés : « News Search », « Blog Search », « Vidéo search », … Vous supprimez tous les machins inutile car vous allez pouvoir mettre vos blogs préférés vous-même. Pour se faire vous cliquez sur la croix en haut à droite de chaque pavé.


Quand le ménage est fini, vous obtenez ceci. J’innove : je fais des flèches de couleur.


Au bout de la flèche verte, le nom de votre page (vous pouvez la renommer en cliquant dessus). Au bout de la flèche rouge, un premier onglet. Je vais le renommer en cliquant dessus pour la suite de ma présentation. Je vais l’appeler « blogs bataves ». Au bout de la flèche bleue, un « + » qui vous permettra de c réer des signets.

Je vais directement cliquez dessus pour créer une catégorie : « blogs de gros réacs avec du poil dans les oreilles », que je vais résumer en « Réacs ». J’obtiens donc cet écran.


Le machin me demande d’entrer les sujets que je veux surveiller. Ne saisissez rien, fermez directement ce truc avec la croix au bout d’une flèche d’une couleur assez traditionnelle (ce qui est normal pour les réacs). Ensuite, cliquez sur « nouvel onglet 1 » et changez le nom.

Vous pouvez commencer !


En cliquant sur « ajouter du contenu », vous pourrez… ajouter du contenu.


Cliquez sur « ajoutez un flux » (flèche rouge). Dans la zone de saisie (j’ai oublié la couleur que j’ai choisie, le vert probablement), vous pouvez mettre le nom d’un blog. Je vais ajouter http://didiergouxbis.blogspot.fr (je suis resté dans l’onglet « réac »). Ensuite, vous cliquez sur ajouter un flux et vous obtenez ceci :


Il y a plein de pavé. Vous cliquez sur le premier. Le machin vous demande une confirmation. Vous cliquez sur « Ajouter à ma page ». En haut à droite de l’écran, vous avez une grosse croix grise, vous cliquez dessus pour fermer la zone pour ajouter du contenu.


Au bout de la flèche verte (de mémoire), on voit que j’ai 100 billets « non lus » sur cette page. Au bout de la flèche rouge, on voit que j’ai 100 billets restant sur le blog de Didier Goux.

Didier, j’ai tout lu (sauf la tartine de ce matin, je me la réserve pour le comptoir). Si c’est indiqué « non lu », c’est parce que je viens de créer un nouveau compte pour l’exemple.

Vous cliquez sur le « 100 » et tous les blogs passent en lus. En cliquant sur un billet, vous pouvez le lire et le marquer en « lu » ou « non lu ». Je vais marque le dernier billet de Didier en « non lu » sinon il va faire la gueule.

Pendant que vous avez le dos tourné, je vais ajouter mon politique, mon comptoir et les deux de Sarkofrance dans la partie « blogs bataves ».

Pour faire un exemple concret, j’ai mis en « non lu » le dernière billet d’un blog de Sarkofrance et de mon blog politique. Je me retrouve donc avec deux billets à dire dans les blogs bataves et un chez les réacs.


Et la flèche rose, me demanderez-vous. Cliquez sur le bouton, pour voir. Non, pas sur l’illustration de mon billet, andouille, sur ton netvibes.

Tu obtiens ce magnifique écran :


Cliquez sur « tous les flux » en haut à gauche ou sur ceux d’un onglet. Tous les billets non lus sont affichés dans l’ordre « chronologique inverse ». On voit par exemple, qu’il me reste trois billets à lire, dont le mien (mais je ne me lis pas, c’est trop mal écrit, je m’abonne pour me faire plaisir).

Tiens ! L’heure affichée est mauvaise. Tant pis.


Vous pouvez alors lire le billet sans aller sur son blog, ce qui vous évite de vous salir les mains quand il tourne un peu trop facho. En cliquant sur le titre de billet, vous irez sur son blog et pourrez mettre un commentaire pour l’incendier prodigieusement.

La flèche est d’une couleur indéterminée. En cliquant sur le bazar, vous pourrez remettre le billet en cours dans l’état « non lu » pour y repasser plus tard ou pour vous rappeler de lire tous les commentaires.

Voila…

N.B. : Je n'utilise pas Netvibes... Il n'est pas très pratique pour suivre beaucoup de blogs.

Yanobs Reader pour remplacer Google Reader

De toutes les applications que j'ai testées pour remplacer Google Reader, c'est très certainement Yanobs Reader qui est la plus proche de Google Reader.

C'est basé sur Tiny Tiny Rss mais ça offre un hébergement en plus. 

Il y a un tas de fonctions sympathiques, la possibilité de faire des filtres, de générer un nouveau flux "agrégeant" vos propres flux, ... Je découvre au fur et à mesure.

Juste un truc, vous pourrez importer vos flux à partir du fichier OPML généré par Google Reader dans Takeout. Cliquez sur "Actions" (en haut à gauche), puis sur "préférences" puis sur "flux" puis sur OPML.

Par contre, les flux mettent assez longtemps à se mettre à jour... J'ai lancé ça se matin vers 10 heures et à 12 heures, je n'ai récupéré qu'une vingtaine de blogs. C'est normal mais surprenant. 

Je suppose en plus qu'ils ont eu des problèmes de charge, tant de gens l'essayant.

N.B. : Via les commentaires de ce blog, je suis en contact avec les tauliers. Les versions pour smartphone sont en cours. La version "web" sur iPhone est déjà utilisable.

Facebook: quelles publications de vos amis vous agacent le plus?

« Plus de la moitié des Britanniques ont limité leur utilisation du réseau social, selon une étude publiée ce jeudi. La faute reviendrait à des amis virtuels qui irritent par leurs publications quotidiennes. Et vous? Qu'est-ce qui vous ennuie chez vos amis sur Facebook ? » Nous indique l'Express. 

Quelques exemples :
"1) Les gens qui témoignent de leurs pratiques sportives et qui détaillent leur perte de poids (pour 53% des sondés) 
2) Ceux qui parlent de nourriture et qui agrémentent leurs messages de photos d'aliments. Passées au préalable par le service Instagram, bien entendu (45%) "
"4) Les invitations à des jeux ou autres applications de divertissement. On a tous reçu une invitation pour jouer à City Ville? (37%)"

Adieu Corinne ! J'ai supprimé une amie Facebook parce qu'elle me gonflait à m'envoyer plusieurs invitations par jour à un jeu que ne connais pas. Peut-être celui-là ? Le pire est que j'ai moi-même envoyé des tas d'invitations à Diamond Dash à des braves gens sans me rendre compte que ça pouvait gêner. 

C'est David qui a récemment fait le ménage dans ses "amis" pour ne garder que ceux qu'il connait réellement. Moi j'avais commencé puis j'ai abandonné... Jusqu'à ce matin quand j'ai viré Corinne. 

Les statuts des gens ne me dérangent pas pour peu qu’ils ne soient pas trop nombreux (au début je supprimais facilement les bavards et je continue à le faire dans Google+). Ils font ce qu’ils veulent.

Ce qui me gène le plus, ce sont les publicités que nous impose Facebook dans la version pour smartphone. 


Fin de Google Reader : le retour de la censure ?

Mashable fait un intéressant article (en anglais) à propos de la suppression de Google Reader. : dans beaucoup de pays, les blogs ou des sites web sont interdits par le Gouvernement. La lecture des billets ou articles étaient néanmoins possibles dans Google Reader.

Ainsi, de nombreux internautes n’auront plus accès à l’information.

Sans compter les blogueurs français dont le proxy du bureau coupe l’accès à des sites web.

18 mars 2013

Vive Flipboard !

Ne le dites pas à mon chef : pendant la réunion d’une heure trente, cette après-midi, j’ai redécouvert Flipboard dont je parlais dans mon billet de ce midi ! Je ne comprends pas que je ne connaissais pas ce machin absolument génial avant, pour suivre les flux, pour lire Twitter, Facebook et Google+… et l’actualité.

C’est le machin pour lire Twitter qui m’a le plus intéressé, on a une prévisualisation assez bonne des articles mis en lien. Voyez l’illustration à gauche (où il n'y a justement aucun lien, voir plus bas pour la bonne illustration). Dans la deuxième illustration, à droite, on voit un menu que je viens de découvrir. En cliquant sur la flèche à coté de la page on a accès à des fonctions…

Etonnamment, il n’y a pas de page Wikipedia en Français pour ce machin. Je me lance donc dans une habile traduction de la traduction fournie par Google Translate.

« Flipboard est un réseau social d'agrégation, un logiciel d'application permettant de suivre des flux au format magazine pour Android et iOS.

Il récupère le contenu
-         des médias sociaux et autres sites Web et les présente sous forme de magazine et permet aux utilisateurs de les partager à travers leur réseau social et
-         des flux RSS à partir des sites Web qui ont établi un partenariat avec la société.

Initialement conçu spécifiquement pour l'iPad, en Décembre 2010, il a été adapté à l'iPhone et l’iPod Touch [puis sur Android].

L’application est produite par Flipboard, Inc, une société de logiciels basée aux États-Unis fondée en 2010 par Mike McCue et Evan Doll et basée à Palo Alto, en Californie.

Selon McCue et Doll, l'application a été pensée lors d'une séance de remue-méninges entre eux, au cours de laquelle ils ont essayé d'imaginer ce que le web ressemblerait s'il était conçu à partir de zéro. Lors de la conception, ils ont mis l’accent sur le web social et la capacité de consommer le contenu dans un graphisme et un format proche de celui d’un magazine.

La réaction du public était plutôt positive, certains appelant le surnommant « tueur d’application i Pad ». Apple a également réagi positivement et a nommé l’application d'application Apple de l'année en 2010. Une nouvelle mise à jour du logiciel a apporté de nouvelles fonctionnalités telles que le support de Google Reader. Cette mise à jour a également reçu la plupart des critiques favorables.

Le 15 mai 2011, Flipboard a été bloqué par la Grande muraille de Chine. McCue a déclaré sur son fil Twitter - "La Chine a maintenant officiellement bloqué Flipboard". La société a ensuite publié sa première édition internationale de la Chine. A partir de Février 2012, la société a commencé l'autocensure si l'utilisateur utilise l'application à partir de la Chine. Le guide de contenu pour la Chine ne comprend pas Twitter et Facebook. Les abonnements existants pour Twitter ou Facebook sont automatiquement supprimés. 

L'interface utilisateur de l'application est intuitive et conçue pour « feuilleter le contenu ». Une fois les flux ont été mis en place, la première page vue lorsque l'application est ouverte une liste visuelle du contenu auquel on est abonné. » En page d’accueil, on « voit » le dernier élément publié. Voir la troisième illustration, à gauche (le hasard fait que c’est le tweet émis automatiquement pour mon dernier billet, s’il avait eu une illustration, elle se serait affichée - comme pour le pavé Google Reader).

Si je clique dessus, on voit un premier aperçu de mon billet (illustration à droite). En première illustration, en haut, une page du machin avec trois tweets consécutifs sans lien.

A noter néanmoins, j'ai l'impression qu'elle consomme de la batterie (en 90 minutes, l'iPhone était à 63%, alors que généralement, il perd 15% par heure).

Pourquoi Google Reader est-il plus rapide que les autres produits ?

Même The Economist a fait un article sur la disparition de Google Reader. Du coup, je fais un court billet pour signaler un passage qui m’intéresse, suite à mon récent billet fleuve sur le fonctionnement des fichiers RSS. Google Reader a réellement fait des modifications pour aller lire plus souvent les fichiers tout en allégeant le nombre de requêtes : « Si un million d’utilisateurs de Reader sont abonnés au flux du New York Times, Google n'a qu'à faire une seule requête pour récupérer le fichier. » Par ailleurs, les flux sont mis à jour en cas de modification.

Par exemple, si un blogueur de gauche fait un billet avec des fautes d’orthographe et que vous les lui signalez et qu’il les corrige, quand vous reprenez l’article dans le Reader, il est mis à jour.

Ceci explique peut-être pourquoi Google Reader semble plus rapide que ses concurrents pour détecter les nouveaux billets.

Après Google Reader

C'est décidément le sujet qui passionne : la fin de Google Reader et son remplacement. Pierre me communiquait un article hier : Google s'apprêterait à lancer un machin pour commercialiser les versions électroniques des journaux. D'ici à ce qu'ils ferment Google News, aussi...

Je n'y crois néanmoins qu'à moitié : d'autres applications permettront de lire les flux.

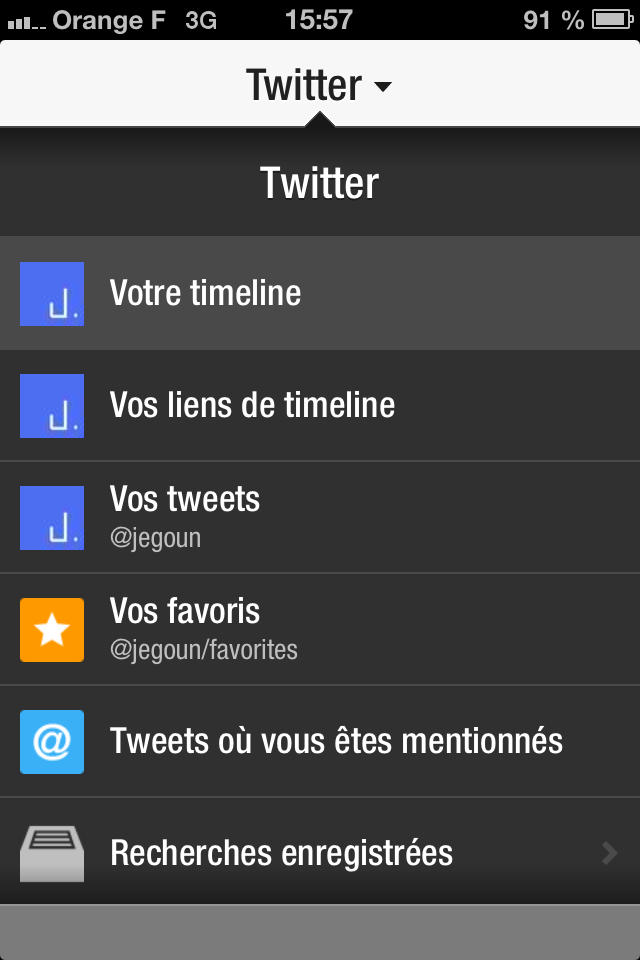
Parmi les solutions de remplacement, je teste depuis ce matin Flipboard c'est très plaisant et pas seulement pour lire les flux ! Ça permet de suivre sa TL Twitter (illustration) et son mur Facebook. Mais il n'y a pas d'application pour le web : impossible à utiliser sur un PC.

Par contre, comme Netvibes, les flux mettent du temps à arriver alors que c'est immédiat avec Google Reader.

Je teste actuellement The Old Reader, un nouveau machin comme son nom de l'indique pas. Mais il semble victime de son succès et est encore en version bêta. Il dispose de fonctionnalités de type "réseau social"... J'y reviendrai (probablement très bientôt).


Edit : The Old Reader étant considéré comme un réseau social, il est bloqué par le proxy du bureau...

16 mars 2013

Les vraies raisons de la suppression de Google Reader

Dans le blog politique, j’ai fait un long billet sur l’avenir de l’informatique et j’en tire une espèce de conclusion à propos de la disparition annoncée de Google Reader. D’une part, la disparition de Google Reader pourra pousser des gens vers Google+. Mais c’est une bricole. D’autre part, Google Reader est un des principaux moyens pour faire de « la veille ». Quand les gens n’auront plus ce machin pour faire de la veille, ils feront autrement, probablement, mais ne trouveront plus de contenu intéressant à diffuser dans les réseaux sociaux comme Facebook et Twitter. Ces derniers se retrouveront vidés de leur consistance et les usagers seront obligés d’aller ailleurs pour retrouver de l’information… Dans Google+ ?

C’était la première raison.

Hier, j’ai fait un long billet pour expliquer ce que sont les flux RSS. Ce sont des petits fichiers à côté des blogs que vont chercher les lecteurs de flux mais aussi tous les machins qui les utilisent comme l’application qui balance mes blogs dans Twitter ou Facebook ou le machin de Blogger qui forme les blogrolls dynamiques de nos blogs (le plus récent billet en haut).

Ce matin, pour me préparer à l’après Google Reader, j’ai fait ma première revue de blog avec Netvibes (c’est pas mal, finalement, mais ça manque un peu de fluidité sur l’iPad). Je me suis rendu compte que les billets arrivaient bien plus tard que dans Google Reader. Par exemple, j’ai fait un billet sur mon blog politique, ce matin. Immédiatement après, j’ai fait ma revue de blog, il était bien dans Google Reader. C’est à ce moment là que j’ai eu l’idée de faire ma revue de blog avec Netvibes. Il n’y était pas. Après cette dernière, je suis revenu à Google Reader, il y avait « un tas » de nouveaux billets qui n’étaient pas dans Netvibes…

J’en tire la conclusion que Netvibes va beaucoup moins souvent que Google Reader lire ces petits fichiers. Google Reader a donc mis en place une infrastructure gigantesque pour gérer tout ça et avoir les flux en permanence.

Et les coûts sont considérables en regard d’un service rendu gratuit.

C’était la deuxième raison.

Le moteur de recherche Google me donne de moins en moins de satisfaction pour certaines recherches. Il y a trop d’information pour trouver de manière sûre ce que l’on cherche, surtout avec les pros du référencement. Par ailleurs, Google privilégie l’actualité. L’autre jour, je cherchais les visites de Nicolas Sarkozy à Dijon. J’ai eu du mal, tant Google était pollué avec la visite de Hollande dans cette ville. Par ailleurs, quand on fait une recherche, on tombe toujours sur les mêmes sites. Vous cherchez la recette des choux farcis, vous tombez sur Marmiton. Vous cherchez autre chose, vous tombez sur Wikipédia.

Google finit par ne plus être le point d’entrée du web et est juste un intermédiaire vers Wikipedia ou Marmiton… J’ai fait la recherche de la recette des choux farcis dans Yahoo, ça tombe aussi dans Marmiton.

Le plus drôle est qu’une grande partie des utilisateurs de Facebook doivent taper Facebook dans le Google qu’ils ont en page d’accueil.

Google se sent à la ramasse pour son moteur de recherche.

C’était la troisième raison

Elle appelle la quatrième qui n’est encore qu’une supposition de ma part. Google+ deviendra Google. Quand vous taperez www.google.com, vous n’arriverez plus sur le moteur de recherche mais sur la page d’accueil de Google+. Les gens seront incités à y faire leurs recherches. Et la recherche sur le web ne sera plus qu’une option dans le nouveau menu qu’ils nous concoctent. Les gens auront d’abord un contenu qui a été recommandé par leurs proches.

C’était la quatrième raison.

C’est très bien Google+, on y trouve plein de recette de choux farcis ailleurs que chez Marmiton, recommandées par des vrais gens. Marmiton n’aura plus qu’à payer Google+ pour promouvoir sa page de recette de choux farcis… Et Marmiton sera obligé de mettre toutes ses recettes sur sa page Google+ pour avoir du trafic.

C’était la cinquième raison.

Pour être au top de l’actualité et du contenu, Google est obligé de scanner en permanence tout le web (et de lire en permanence les fichiers avec les flux RSS). Le nombre de pages web croit à une vitesse grand V et les moyens que doit fournir Google pour connaître tous ça font que Google doit avoir des moyens informatiques considérables (comme pour Google Reader) pour un outil de moins en moins pertinent.

Le coût est énorme.

C’était la sixième raison.

On est bien d’accord que les quatre dernières raisons n’ont pas grand-chose à voir avec Google Reader. La suppression de ce machin (comme de Feedburner) rentre dans une stratégie globale de Google de se recentrer sur son réseau social phare où les pages et les communautés donneront toutes les réponses aux besoins des internautes, dans un contexte beaucoup plus maitrisé que le gigantisme du web.
 

15 mars 2013

Internet, les blogs et RSS pour les nuls

Parallèlement à l'arrêt de Google Reader, on parle beaucoup de RSS. Par exemple, un commentateur a un de mes billets a dit : "Oui il faut pas confondre google reader et flux RSS car même si le RSS n'a pas eu le succès escompté mais c'est un outil indispensable pour faire sa veille." Le hic : RSS n'est pas un outil. C'est un format de fichier. Les gens évoquent RSS mais ne savent pas ce que c'est... Ils utilisent des mots sans savoir ce qu’il y a derrière. Je dois avouer que j'ai eu beaucoup de mal à comprendre, retroussons les manches... Et reprenons à la base. Tu permets que je te tutoie ?

Quand, dans ton navigateur, tu cliques sur un lien, tu choisis un favori ou tu tapes l'adresse de mon blog, tu envoie, en fait, une requête http. C'est un peu comme si tu faisais un numéro de téléphone.

Il va donc partir sur le réseau http://www.aubistrogeek.com avec un pas d'autres informations (où tu es, quel navigateur tu utilises, comment tu es arrivé sur le site, par exemple). Ton fournisseur d'accès va envoyer tout ça à un serveur de routage (les machins DNS) qui va savoir où est le serveur qui gère aubistrogeek.com pour lui envoyer tout ce bordel.

En fait aubistrogeek.com est un pseudo pour jegweb.blogspot.com. C'est donc le serveur blogspot.com qui va recevoir la demande. Blogspot est le machin qui héberge les blogs Blogger, la filiale de Google qui gère les blogs. D'autres blogueurs ont fait des choix différents des miens. Ils peuvent, par exemple, avoir leurs propres serveurs chez eux. Le machin DNS saura où envoyer la demande (il va convertir le nom de domaine en adresse IP, mais je ne vais pas descendre jusque là).

Nous en étions au moment où blogspot.com reçoit la demande pour jegweb.blogspot.com. Il va se dire : "tiens ! Un appel pour le blog jegweb." Et transmettre tout ça à l'application qui gère mon bordel.

Celle-ci va alors préparer une page HTML que le serveur va renvoyer à votre navigateur pour lui donner des instructions. Notre navigateur va recevoir çà et sous votre regard émerveillé mon blog va s'afficher...

Que va contenir la page HTML ? 

Tu peux regarder toi-même, si tu veux. Par exemple, si tu es avec Firefox, tu trouveras dans les menus une option "outil pour les développeurs" puis "afficher le code source". Tu n'y comprends rien ? C'est normal... Mais il y a 10 ou 12 ans, c'est ce genre de merdier qu'il nous fallait taper si on voulait gérer un serveur web.

La page HTML va contenir, globalement des instructions d'affichage, du texte à afficher, des adresses d'images à afficher, des bouts de "scripts",...

Par exemple, pour mon blog, il y aura l'instruction : "Hé ! Banane ! Affiche donc en haut à gauche et en gros : Partageons l'addiction" puis "Hé ! Banane ! Affiche donc en dessous le slogan du blog mais en plus petit".

Ces instructions sont appelées : balises html. Il va y en avoir pour un tas de trucs, comme afficher du texte, insérer un lien, afficher une image à aller chercher sur un serveur, exécuter un bout de programme,...

T'as vu ? En haut à droite, j'ai un machin avec les cercles Google+. Je suppose que dans la page HTML, j'ai un bout de commande qui dit : vas donc voir sur les serveurs de Google+ ce qu'il faut faire pour "le comptoir de Jegoun". Le serveur Google+ enverra alors des instructions à ton navigateur...

Tu as bien suivi ?

Je résume... Tu tapes http://www.aubistrogeek.com. Le réseau envoie ça à un serveur Blogspot dont une application va transmettre une page html avec des instructions pour ton aviateur qui, dans la joie et la bonne humeur, exécutera ces instructions pour que tu puisses voir mon blog.

Je vais m'attarder un peu sur le HTML. C'est important. C'est une norme qui permet, globalement, à un serveur de parler dans une langue connue par le navigateur. La norme évolue sans cesse. Elle est définie par le W3C (World Wide Web Consortium) qui est un organisme à but non lucratif, composé des industriels, des gens qui font des navigateurs. Les anciennes versions étaient très lourdes et on a vu éclore des tas de machins qui se sont greffés dessus, comme le Javascript qui s’est greffé dessus pour nous faire des machins comme on voit actuellement. Nous en sommes à HTML 5 qui est commence à voir le jour. Elle permet un tas de nouveaux trucs, comme l'affichage de vidéos en streaming sans passer par des serveurs comme YouTube et sans Flash ce qui sera bien pratique mais on s’en fout, à ce stade.

Bref, comme dit Wikipedia : « L’Hypertext Markup Language, généralement abrégé HTML, est le format de données conçu pour représenter les pages web. » Je répète : c’est la base ; ça permet à un serveur de parler à un navigateur.

Tant que je parle de normes, il me faut évoquer XML. C’est aussi un machin défini par le W3C. C’est ce qui permet de transporter des données sur le web. Hier, par exemple, à propos de la disparition de Google Reader, on disait qu’on pouvait télécharger la liste des blogs auxquels on est abonné. Je te disais comment le faire… Si tu l’as fait, regarde le fichier vite-fait. C’est important que des gugusses fassent ce genre de normes, sinon on serait toujours à échanger des 0 et des 1 sans savoir quoi en faire… Il y a plein de normes, comme ça ! Par exemple, IMAP est la norme qui vous permet de récupérer les messages dans une messagerie.

Revenons aux blogs. Votre navigateur ne sait pas ce qu’est un blog. C’est donc le serveur web qui va lui envoyer les instructions en HTML, voire des données en XML (ou un mix des deux, le langage XHMTL).

Qu’est-ce que le serveur de blog ?

C'est, d'un côté, ce que je vais appeler une application, c'est-à-dire un ensemble de logiciels et, de l'autre côté, une base de données, soit un ensemble de fichiers. L'application va utiliser ces données pour préparer une page HTML pour ton navigateur.

Cette base de données à plusieurs volet : la description du blog, les billets et les machins comme les images qui sont affichées dans les billets.

La description du blog est ce qui permet sa mise en page, la couleur du fond, le contenu des colonnes, la police de caractères, le détail de la blogroll,... Appelle-ça comme tu veux : feuille de style, CMS,... peu importe. Pour des lascars comme moi, qui gèrent leurs blogs avec Blogger, tout cela est presque transparent.

Les "billets" est la partie qui évolue au quotidien est qui contient la description des billets : le titre, le texte, la présentation, la position des images (stockées à part dans ce que j'appelais "les machins", ci-dessus).

Je résume à nouveau. Pour l'affichage d'un blog, nous avons trois trucs qui interviennent : ton navigateur, le serveur web et la base de données.

Le serveur web est très fort : il va pouvoir préparer les pages html de différentes manières selon que tu consultes le blog d'un ordinateur ou d'un smartphone.

On a donc 3 machins, le navigateur, le serveur et la base. On appelle ça une architecture 3 tiers ("tier" est un mot anglais qui veut dire niveau, ce que je sais depuis peu). Ceci a peu d'importance dans le cadre du présent billet mais c'est pour ta culture générale parce que c'est la base de l'informatique actuelle. Prends l’exemple de ta banque. Pour consulter tes comptes tu as un navigateur, un serveur et une base de données. Ton conseiller financier aussi. Le navigateur et la base de données seront les mêmes. Seul le serveur change... Réfléchis bien à ça. La standardisation par les normes est importante. Vos navigateurs vont parler le même langage, HTML, aux deux serveurs différents qui parleront avec le même langage à la base de données.

Deux serveurs différents ? Pour les blogs, c'est pareil. Par exemple, pour voir mon blog, j'utilise (et toi aussi) un serveur blogspot.com (redirigé à partir de aubistrogeek.com). Pour gérer mon blog, j'utilise un autre serveur, blogger.com. En fait, ce sont plus précisément trois serveurs : un pour la consultation sur ordinateur, un, très proche, pour la consultation sur smartphone, un pour la gestion du blog. Pour la banque, c'est pareil. Tu auras un serveur pour consulter tes comptes sur ton PC et un autre pour consulter ton compte à partir d'un automate de type « distributeur de billets ».

Revenons à nos moutons.

Je disais qu'un blog est avant tout une base de données. Ça te troue peut-être le cul mais c'est comme ça. Les gens qui ont un blog "Wordpress.org" le savent très bien.

Cette base de données est composée de trois machins, disais-je... J'ai oublié quelques détails. Par exemple, elle contient aussi les commentaires aux billets.

Et les flux RSS ?

Ils font partis des machins que j'ai oubliés. Le fameux flux RSS ! C'est en fait un petit fichier à côté du blog. Tiens ! On parle parfois de flux ATOM. C'est à peu près pareil. Ce sont deux standards différents mais tous les deux basés sur la norme XML que j'évoquais plus haut.

Le flux RSS est un fichier qui est mis à jour quand on publie un nouveau billet, notamment. Il contient une description rapide du blog et les derniers billets, soit complets, soit tronqués. S'ils sont complets, ils peuvent avoir le même format que les billets. D'ailleurs, si tu consultes un de mes billets, il aura la même tronche dans Google Reader que sur mon blog.

L'intérêt du fichier RSS est qu'il est tout petit et "statique" alors que le blog lui même contient un tas de saloperies diverses (bannière, image de fond, blogroll, les commentaires, le soft pour gérer les commentaires...). Le fichier HTML est généré à chaque affichage du blog.

Si tu utilises Netvibes ou une application sur smartphone, tu auras remarqué que l'affichage prend quelques temps : il faut que le serveur qui gère ça aille voir si les flux RSS de chaque blog ont été modifiés depuis la dernière fois puis, le ça échéant, le télécharge. Si besoin, il va le traduire en HTML pour que ton navigateur l'affiche.

Autour des flux RSS, il y a une espèce de double malentendu. D'une part, la notion de flux est un peu abusive. Ça vient probablement de l'anglais ou d'un vieil usage dans l'informatique. D'autre part, l'abonnement aux flux ne vient pas du fait qu'on s'abonne à un blog mais qu'autrefois il fallait être abonné pour pouvoir lire un flux. Vous vous abonniez à un blog dans votre agrégateur et, lui, s'abonnait au flux pour avoir l'autorisation de le lire.

Avec le terme abonnement, on avait l'impression que c'est l'abonné (l'agrégateur) qui recevait automatiquement l'information (comme on reçoit dans notre boîte à lettres un journal auquel on est abonnés) alors que c'est bien l'agrégateur qui va chercher le fichier avec ce qu'on appelle un flux.

L'utilisation quasi obligatoire à une époque de feedburner rendait cette notion d'abonnement plus réelle. Comme Google Reader et Feedburner étaient dans la même boutique, ça facilitait la chose.

Bon...

Il n'y a pas que les agrégateurs ou lecteurs de flux qui utilisent les flux RSS. Par exemple, les billets de ce blogs sont publiés automatiquement sur mon compte Twitter et ma page Facebook. Pour ce faire, j'utilise dlvr.it qui va vérifier périodiquement le flux de mon blog pour voir s'il y a du neuf.

Tous les dix minutes, dlvr.it appelle Blogspot : "hé ho ! Y'a du neuf chez aubistrogeek.com ?", Blogspot renverra la question à Blogger qui renverra la question à Feedburner... Vous imaginez le bordel !

Autre exemple... Vous voyez en haut de ma colonne la plus à droite. Il y a une blogroll dynamique. Les blogs y sont affichés avec le dernier billet de chacun. C'est basé sur les flux.

Allez sur mon blog politique. Je ne sais plus combien de blogs sont présentés. Disons 150. A chaque fois qu'une andouille ouvre mon blog, il faut que blogueur aille voir les flux de chacun d'entre eux pour aller voir les billets de chacun (et ne présente que les 25 derniers). Vous avez vu ce bordel ? 8 ou 900 fois par jour, il va interroger 150 blogs, tout ça pour quelques loustics qui cliquent...

Je résume. Le flux RSS et son concurrent, le flux ATOM, sont des petits fichiers à côté des blogs que vont périodiquement mais fréquemment consulter des applications pour demander : "alors, quoi de neuf sur ce site ?". La réponse est négative dans 100% des cas.

J'espère que vous avez tout compris jusque là ! Des puristes pourront apporter des précisions si je me plante. Qu'ils ne focalisent pas sur les détails, je ne fais que vulgariser. Merde, quoi. Vive la vulgarisation.

Un dernier détail. Les flux RSS ne sont pas dédiés aux blogs ou aux sites web. Par exemple, si vous suivez le compte Twitter @leftblogs, il contient tous les billets de notre groupe de blogueurs gauchistes. Il est diffusé par dlvr.it sur la base d'un flux RSS qui agrège les flux RSS des blogs de tous les membres du groupe. Autre exemple, vous pouvez vous abonner à un flux RSS avec l'ensemble des tweets que vous avez marqué comme favoris.

Il existe, ainsi, des centaines de millions, probablement des milliards de flux RSS. C'est le bordel.

Bref…

Quand j’ai commencé à bloguer, fin 95, on ne parlait pas des flux RSS. On allait dans les blogs à la main, de blogroll en blogroll. La notion a commencé à se développer par la suite, j’ai appris que j’avais moi-même un flux RSS et que tous les blogs en avaient.

Techniquement, ça restait un peu du chinois. Les gens parlaient de syndication ou de mots compliqués comme ça. On y comprenait que dalle. C’est en 2007 qu’on a commencé à comprendre que la « syndication de contenu » était très importante et l’avenir du web.

On a commencé à s’abonner aux blogs dans Netvibes, qu’on aimait bien, c’était un truc Français. Il est sorti en 2005, trois semaines avant que Google ne sorte son service… On est passé à Google Reader pour différentes raisons, notamment qu’il offrait des services complémentaires.

RSS ne mourra pas. Google Reader sera repris par Feedly, ils ont vraisemblablement des accords. Google Reader n’avait plus aucun intérêt pour Google qui développe une autre approche du web.

C'est quoi RSS ?

Il faut que je réponde à mon commentateur. Ce n'est pas un outil.

C'est un petit fichier, annexé aux sites web, qui décrit les dernières modifications de celui-ci. Pourquoi voudriez-vous que ça disparaisse ?